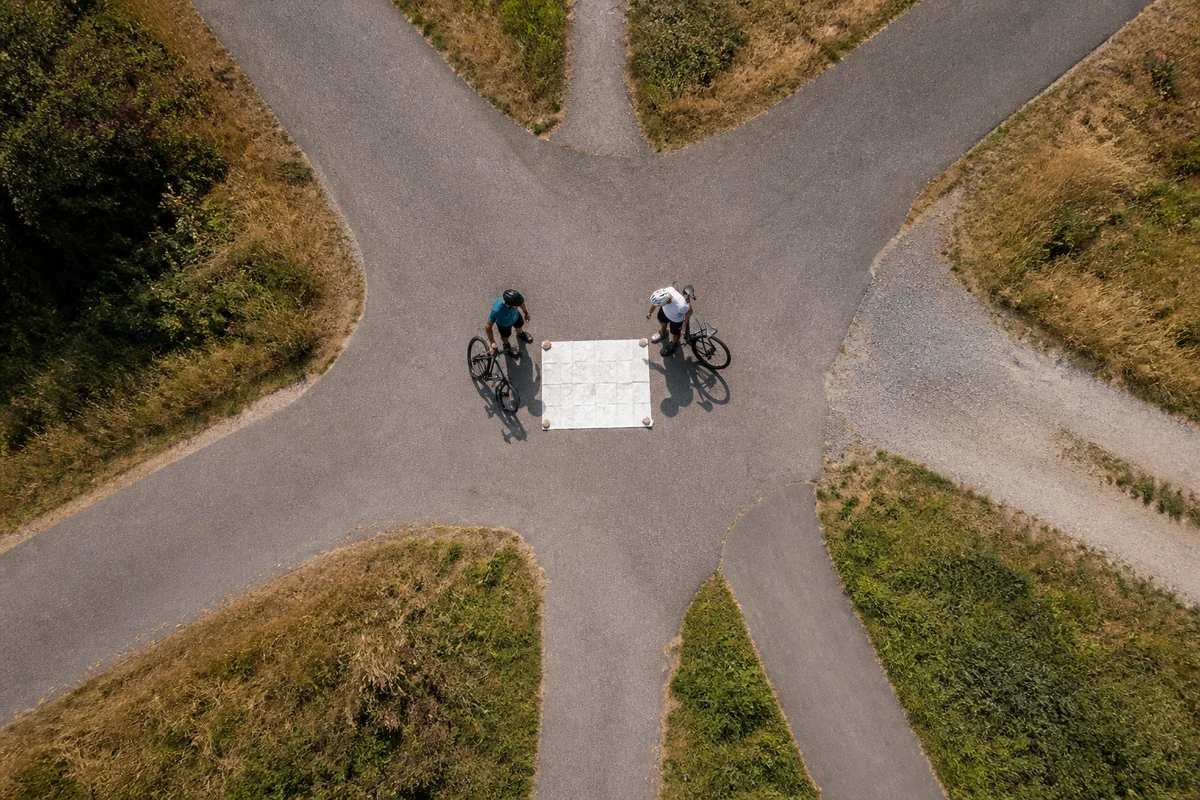
Zwei Fahrräder stehen an einer Weggabelung, an der sich Asphalt, schmaler Radweg und eine steile Nebenstraße auseinanderziehen. Die Szene ist ein Gedankenmodell, keine behauptete Tour: Zwei Freunde wollen nach dem Sport noch zu einer Geburtstagsrunde, einer hat wenig Lust auf Autoverkehr, die andere möchte nicht völlig verschwitzt ankommen. Auf einer großen Papierkarte sieht das Ziel nah aus. In der Wirklichkeit kann der direkte Weg eine Treppe enthalten, die flache Strecke an einer Baustelle enden und die ruhige Variante einen erheblichen Umweg machen. Öffnet man Google Maps, erscheint nach kurzer Zeit eine Linie. Das wirkt so mühelos, dass im Gespräch schnell alles „der Algorithmus“ oder gleich „die KI“ heißt. Aber zwischen Wunsch und Linie liegen verschiedene Tätigkeiten. Jemand muss Straßen, Kreuzungen und erlaubte Bewegungen als Daten abbilden. Jemand muss festlegen, was eine gute Route bedeutet. Ein Verfahren muss mögliche Wege vergleichen. Eine Datenstruktur muss speichern, welche Abzweigung als Nächstes geprüft wird. Ein Programm muss Eingaben, Fehler und Darstellung bewältigen. Ein Git-Repository kann die Versionen dieses Programms aufbewahren. Und maschinelles Lernen kann an manchen Stellen Prognosen liefern, etwa für zukünftige Fahrzeiten. Nichts davon ist dasselbe. Googles aktuelle Routes-API zeigt öffentlich zumindest die äußere Form des Problems: Start, Ziel und Fortbewegungsart gehören zu einer Anfrage; Radfahren ist ein eigener Modus. [9] Welche proprietären Algorithmen Google Maps heute intern genau kombiniert, ist damit nicht offengelegt. Gerade diese Grenze macht die Fahrradtour nützlich: Wir können verstehen, was ein Routenplaner grundsätzlich leisten muss, ohne aus einer Produktseite ein erfundenes Röntgenbild von Google zu bauen.
An der Gabelung zählt nicht der Strich, sondern die Frage
Die erste technische Entscheidung fällt, bevor ein Computer sucht. Was soll „beste Route“ heißen? Kürzeste Entfernung, geringste erwartete Zeit, wenig Steigung, sichere Infrastruktur, wenig Verkehr oder eine Strecke, auf der zwei Menschen nebeneinander reden können? Für ein Lastenrad, ein Rennrad und jemanden mit verletztem Knie kann dieselbe Kreuzung drei verschiedene Antworten besitzen.
Google Maps Platform verlangt bei einer Routenanfrage neben Start und Ziel eine Fortbewegungsart. Die Dokumentation nennt Radfahren, Gehen, Auto, motorisierte Zweiräder und öffentliche Verkehrsmittel als unterschiedliche Modi. [9] Schon dieser Parameter widerlegt die Idee einer neutralen, universell besten Linie. Ein Weg ist gut relativ zu Regeln, Daten und einem Ziel.
Das ist im Alltag der wichtigste Schritt. Wer sagt „der Algorithmus hat mich falsch geschickt“, kann mindestens drei Dinge meinen: Die Karte war unvollständig, das Optimierungsziel passte nicht oder das Verfahren verarbeitete die vorhandenen Angaben schlecht. Erst diese Trennung macht Kritik prüfbar.
Eine Stadt wird zum Graphen, sobald die Räder rollen
Für die Suche muss die physische Stadt in eine Form übersetzt werden, mit der gerechnet werden kann. Kreuzungen, Einfahrten oder andere relevante Punkte werden zu Knoten. Befahrbare Verbindungen dazwischen werden zu Kanten. Einbahnstraßen erzeugen gerichtete Beziehungen; eine gesperrte Passage kann ganz fehlen. Aus Häusern, Asphalt und Regeln entsteht ein Graph.
Dieses Modell ist nicht die Stadt. Es ignoriert Fassaden, Gerüche, den Freund auf dem Rad nebenan und alles, was für die konkrete Frage keine Rolle spielen soll. Gleichzeitig muss es genug Wirklichkeit erhalten. Wenn eine Brücke für Fahrräder nicht passierbar ist, darf eine scheinbar kurze Linie sie nicht als normale Kante behandeln.
Google DeepMind beschrieb 2020 auch Verkehrsprognosen über graphartige Straßennetze: Dort entsprachen Straßensegmente Knoten, Verbindungen bildeten aufeinanderfolgende oder kreuzende Segmente ab. [10] Das war ein spezielles Lernmodell für Fahrzeiten, nicht die vollständige Routenlogik. Es zeigt aber, warum Graphen für Straßen mehr sind als eine hübsche Metapher.
Das Gewicht verrät, was „gut“ heimlich bedeutet
Eine nackte Kante sagt nur, dass eine Bewegung möglich ist. Für eine Entscheidung erhält sie ein Gewicht. Das kann Länge sein, erwartete Fahrzeit oder eine zusammengesetzte Bewertung. Eine steile Straße könnte zusätzliche Kosten bekommen, eine angenehme Radverbindung geringere. Sobald mehrere Merkmale verrechnet werden, steckt im Gewicht eine Vorstellung davon, was zählt.
Damit wird „kürzester Weg“ präziser und politischer zugleich. Der mathematisch kleinste Summenwert ist nur so sinnvoll wie seine Zutaten. Fehlende Baustellendaten können eine Route ruinieren. Eine starke Abneigung gegen Hauptstraßen muss irgendwo als Regel oder Gewicht auftauchen. Ein Algorithmus kann konsequent optimieren und trotzdem eine Strecke liefern, die den beiden Radfahrern nicht gefällt.
NetworkX dokumentiert für Dijkstras Methode genau diesen Kern: Gewichte liegen an Kanten, Pfadkosten entstehen als Summe der durchfahrenen Gewichte. [4] Das ist keine Aussage über Google Maps, sondern ein offenes, prüfbares Beispiel dafür, wie eine Routenfrage mathematisch greifbar wird.
Dijkstra prüft Möglichkeiten, ohne etwas zu „verstehen“
Edsger W. Dijkstra veröffentlichte 1959 eine kurze Arbeit über zwei Graphprobleme. Eines davon sucht zwischen zwei Knoten den Pfad mit minimaler Gesamtlänge, wenn die Kanten positive Längen tragen. [3] Der daraus bekannte Algorithmus beginnt am Start und erweitert systematisch den bislang billigsten erreichbaren Bereich.
An der Fahrradtour gedacht: Zuerst ist nur der Start sicher bei Kosten null. Von dort werden erreichbare Abzweigungen mit ihren vorläufigen Kosten notiert. Als Nächstes wird der noch offene Knoten mit dem kleinsten bekannten Gesamtpreis fest ausgewählt. Von ihm aus werden Nachbarn verbessert. So wächst die Gewissheit nach außen, bis das Ziel erreicht ist.
Dijkstra erkennt dabei weder Fahrradfreude noch Gefahr noch Geburtstag. Er lernt auch nichts aus früheren Fahrten. Er folgt festgelegten Regeln auf vorbereiteten Gewichten. NIST beschreibt einen Algorithmus entsprechend als klar spezifizierten Rechenprozess beziehungsweise als Regeln, die bei korrekter Ausführung ein vorgegebenes Ergebnis liefern. [1] Das ist mächtig – und noch keine KI.
A* schaut zum Ziel, ohne hellzusehen
In einem großen Netz kann eine Suche viel Umgebung prüfen, obwohl das Ziel in einer bestimmten Richtung liegt. A* ergänzt deshalb eine Heuristik: eine Schätzung der noch verbleibenden Kosten. Zur bereits gefahrenen beziehungsweise berechneten Strecke kommt ein plausibler Blick nach vorn. Knoten, die insgesamt vielversprechend wirken, landen früher an der Reihe.
Eine einfache Schätzung könnte die Luftliniendistanz zum Ziel verwenden. Sie kennt weder den tatsächlichen Radweg noch die nächste Baustelle. Sie lenkt nur die Suche. NetworkX weist darauf hin, dass eine unzulässige Heuristik, die verbleibende Kosten überschätzt, die Garantie des kürzesten Pfads zerstören kann. [5] Eine gute Abkürzung muss ihre Grenzen respektieren.
Auch A* ist deshalb nicht automatisch KI. Die Heuristik kann eine von Menschen formulierte Funktion sein. Dass ein Verfahren intelligent wirkt, weil es nicht blind in jede Richtung läuft, sagt nichts darüber, ob es Parameter aus Daten gelernt hat. Zielgerichtet und gelernt sind zwei verschiedene Eigenschaften.
Der Heap hält die nächste Abzweigung oben
Dijkstra und A* benötigen ständig die noch offene Möglichkeit mit dem kleinsten Wert. Man könnte jedes Mal eine ganze Liste durchsuchen. Praktischer ist häufig eine Priority Queue: Sie hält Kandidaten so organisiert, dass der aktuell günstigste schnell erreichbar ist. Das ist eine Datenstrukturaufgabe, keine neue Definition des Suchverfahrens.
NIST beschreibt Datenstrukturen als organisierte Information, meist im Speicher, die Algorithmen effizient nutzbar macht; zu ihnen gehören Operationen wie Suchen, Einfügen oder Balancieren. [2] Pythons Modul `heapq` bietet dafür einen Min-Heap. Das kleinste Element liegt an der Wurzel und kann entnommen werden, während die Heap-Eigenschaft erhalten bleibt. [6]
Auf dem Asphalt gibt es natürlich keinen kleinen Baum aus Speicherzellen. Der Heap ist die Ordnung hinter der Suchfront. Ein anderer Programmierer könnte dieselbe algorithmische Idee mit einer anderen Priority-Queue-Implementierung umsetzen. Algorithmus und Datenstruktur arbeiten zusammen, bleiben aber austauschbare Entscheidungen.
Aus der Methode wird erst im Programm eine brauchbare Tour
Ein paar Zeilen Pseudocode zeigen noch keine Karte, lesen keinen Standort und erklären keinen Fehler. Ein Python-Programm müsste Graphdaten laden, Start und Ziel prüfen, Gewichte berechnen, eine Priority Queue bedienen, Vorgänger speichern, den gefundenen Weg rekonstruieren und auf nicht erreichbare Ziele reagieren. Hinzu kommen Oberfläche, Datenschutz, Aktualisierung und Ausgabe.
Die Python-Dokumentation beschreibt Programme als ausführbare Codeblöcke wie Module und Funktionskörper. Bei der Ausführung entstehen Frames; Namen werden in bestimmten Gültigkeitsbereichen gebunden. [7] Diese Sprachregeln gehören zur konkreten Umsetzung. Dijkstras mathematische Methode kennt weder einen Python-Import noch eine Exception.
Darum kann derselbe Algorithmus in Python, Rust, JavaScript oder auf Papier existieren. Und zwei Python-Programme können denselben Algorithmus verwenden, aber bei Datenprüfung, Speicherbedarf und Nutzerführung völlig verschieden sein. Wer sagt „ich habe einen Algorithmus auf GitHub geladen“, meint meistens eine Implementierung, nicht die abstrakte Methode selbst.
Git erinnert sich an Versionen; GitHub ist nicht der Motor
Während die beiden Freunde vielleicht schon fahren, verändert ein Entwickler das Programm: Ein gesperrter Weg soll korrekt ausgeschlossen, eine neue Gewichtung getestet oder ein Fehler behoben werden. Git kann diese Entwicklungszustände festhalten. Das offizielle Glossar definiert ein Repository als Referenzen zusammen mit einer Objektdatenbank und einen Commit als Punkt in einer verknüpften Projektgeschichte. [8]
Im Repository können Python-Dateien, Tests, Dokumentation und Konfiguration liegen. Es bewahrt Versionen und Beziehungen zwischen Änderungen. Es berechnet aber nicht deshalb selbst die Fahrradroute. Erst wenn ein passendes Programm aus dem Bestand ausgeführt wird, verarbeitet die Implementierung Eingaben.
GitHub kann ein solches Git-Repository hosten und Zusammenarbeit, Issues oder Reviews organisieren. Git bleibt das Versionskontrollsystem; GitHub ist ein konkretes Unternehmen und eine Plattform. Der Unterschied ist ungefähr so wichtig wie der zwischen einem Trainingsplan, seinem Ordner und dem Sportstudio, in dem Menschen gemeinsam daran arbeiten.
Bei der Verkehrsprognose kann Lernen wirklich mitfahren
Bis hierher war kein Lernen nötig. Knoten, Gewichte, Dijkstra, A*, Heap und Python können vollständig durch vorgegebene Regeln funktionieren. Maschinelles Lernen wird interessant, wenn ein Wert nicht sauber feststeht, sondern aus vielen Beispielen geschätzt werden soll: Wie lange dauert ein bestimmtes Straßensegment voraussichtlich zu einer bestimmten Zeit?
Google DeepMind beschrieb 2020 ein damaliges System, das Liveverkehr und historische Muster für ETA-Prognosen verband. Graph Neural Networks schätzten Fahrzeiten für sogenannte Supersegmente; diese Prognosen wurden zusammen mit Routen-Kandidaten genutzt, um Wege nach erwarteter Ankunftszeit zu ordnen. [10] Die Quelle belegt diesen historischen Aufbau, nicht die heutige proprietäre Architektur und nicht speziell die Fahrradnavigation.
Die saubere Trennung lautet: Ein gelerntes Modell kann ein Gewicht oder eine Prognose liefern. Ein Algorithmus kann danach Kandidaten suchen, sortieren und darstellen. Auch das Training eines Modells besteht wiederum aus Algorithmen. Trotzdem ist nicht jeder Algorithmus maschinelles Lernen – so wie nicht jedes Fahrrad ein E-Bike ist, nur weil beide Räder und eine Kette besitzen.
An der Kreuzung stellst du jetzt die bessere Frage
Die Linie auf Google Maps ist das sichtbare Ende vieler Verträge. Welche Wege existieren in den Daten? Für welche Fortbewegungsart gelten sie? Was wird optimiert? Welche Werte sind gemessen, welche geschätzt, welche von Menschen festgelegt? Welches Verfahren durchsucht die Möglichkeiten? Welche Datenstruktur hält den Zwischenstand? Welche Programmversion setzt das alles um?
Google veröffentlicht, dass seine Routes-API Routen für verschiedene Modi berechnet und Routen, Abschnitte sowie Schritte zurückgeben kann. [9] Es veröffentlicht damit keine vollständige Zutatenliste des aktuellen Google-Maps-Motors. Eine erwachsene Technikerklärung hält beides gleichzeitig aus: Das Produkt ist konkret genug für ein gutes Beispiel, seine nicht offengelegten Interna bleiben unbekannt.
Die zwei Freunde können nun noch immer über den vorgeschlagenen Weg streiten. Nur der Streit wird besser. Vielleicht war das Kartenmodell falsch. Vielleicht bevorzugt einer ruhige Wege und die andere Geschwindigkeit. Vielleicht war eine ETA-Prognose daneben. Vielleicht optimierte das Programm genau das, worum es gebeten wurde. „Die KI spinnt“ klingt schnell. „Welche Größe wurde hier eigentlich gelernt und was hat danach die Route ausgewählt?“ bringt das Gespräch wirklich weiter.
Geöffnete Quellen zu Routen, Graphsuche, Python, Git und Verkehrsprognosen
- NIST CSRC – Algorithm (standard-reference)
- NIST DADS – Data Structure (standard-reference)
- E. W. Dijkstra / CWI – A Note on Two Problems in Connexion with Graphs (1959) (research-primary)
- NetworkX – dijkstra_path Documentation (technical-primary)
- NetworkX – astar_path Documentation (technical-primary)
- Python Documentation – heapq Priority Queue Algorithm (technical-primary)
- Python Documentation – Execution Model (technical-primary)
- Git – Official Glossary (technical-primary)
- Google Maps Platform – Compute Routes Overview (company-technical-primary)
- Google DeepMind – Traffic Prediction with Advanced Graph Neural Networks (2020) (company-research-primary)
Recherche- und Redaktionsstand: 17. August 2026. Redaktionell verantwortlich: Benjamin Metzig.