Stell dir einen Gruppenchat vor: Jemand schickt ein Bild einer unmöglichen Kreatur, dazu einen Satz, der nur in dieser Runde lustig ist. Beim nächsten Weiterleiten bleibt das Bild, der Satz verschwindet. Eine dritte Person sieht bloß noch ein scheinbar fotografiertes Wesen und fragt, ob das „echt“ sei. Die Szene ist hypothetisch. Der kleine Verlust an Kontext ist real als Problem: Ein synthetisches Meme lebt vom gemeinsamen Lesen, während eine Datei erstaunlich leicht allein weiterreist.
KI kann heute Bilder, Stimmen und kurze Szenen erzeugen. Daraus folgt noch kein gelungener Witz und erst recht kein verlässliches Herkunftssystem für jeden Repost. Was tatsächlich funktioniert, lässt sich an konkreten Plattformen und einem offenen technischen Standard prüfen. Was dabei fehlt, müssen die Menschen entscheiden, die das Bild weiterreichen.
Ein Witz wird im Umlauf gemacht
Das Phänomen „Italian Brainrot“ ist ein brauchbarer Gegenstand, weil es nicht bei einem einzigen Bild stehen blieb. Know Your Meme dokumentiert für 2025 auf TikTok eine Serie synthetischer Tier- und Objekthybride, oft zusammen mit gereimten oder rhythmischen Stimmen. Einzelne Figuren wurden wiedererkannt, umbenannt, verglichen und in neue Kombinationen gesetzt. Das Archiv belegt diese dokumentierte Memeform; seine Aufrufzahlen sind kein Maß für die gesamte Netzkultur. [8]
Gerade die Absurdität macht den Unterschied zum bloßen „Schau, was die Maschine kann“. Eine Pointe entsteht nicht durch die technisch mögliche Mischung zweier Gegenstände. Sie entsteht, wenn andere Menschen ein Muster verstehen und dann anders fortsetzen. Ein vermeintlich missratener KI-Körper kann in einer Runde zur perfekten Reaktion auf einen zu langen Arbeitstag werden; in einer anderen bleibt er ein beliebiges Bild. Das ist eine Deutung, keine Behauptung über eine bestimmte beobachtete Gruppe.
Die schnellen Varianten haben eine soziale Kehrseite. Wer die Vorlage nicht kennt, bekommt manchmal nur das Geräusch eines Insiderwitzes geliefert. Wer als Person oder Gruppe in einen realistisch wirkenden Spott hineingezogen wird, hat noch weniger Grund, die technische Virtuosität zu feiern. Darum ist die Frage „Wurde das mit KI gemacht?“ nützlich, aber zu klein. Ebenso zählt: Wer ist gemeint, wer teilt es, und welcher Satz ging beim Weiterleiten verloren?
Ein Meme ist außerdem keine einzelne abgeschlossene Arbeit wie ein Poster im Rahmen. Es kann als Antwort, Reaktion, Variation oder absichtliche Übertreibung funktionieren. Gerade daran sieht man, warum ein Generator zwar Material bereitstellt, die kulturelle Lesart aber nicht kontrolliert. Ein neuer Empfänger kann die Pointe verschieben oder sie ganz übersehen. Wer den Kontext kennt, kann das komisch finden; wer ihn nicht kennt, braucht womöglich eine Erklärung statt noch einer Variante.
Mehr Ideen sind nicht automatisch bessere Pointen
Eine Originalstudie von Zhikun Wu, Thomas Weber und Florian Müller hat Memeproduktion mit drei Gruppen von je 50 Personen untersucht: ohne KI, mit LLM-Unterstützung und autonom mit LLM. Die Beteiligten mit Assistenz erzeugten mehr Ideen und empfanden weniger Mühe. In diesem Versuchsaufbau stieg die Qualität ihrer Memes dadurch nicht pauschal. Die Autoren berichten zugleich differenzierte Bewertungen von Humor, Kreativität und Teilbarkeit; ihre Resultate sind keine Rangliste sämtlicher Modelle und Szenen. [7]
Das ist ein hilfreicher Dämpfer für zwei allzu einfache Geschichten. Die Maschine ist nicht bloß ein unkreativer Kopierer: In einem klar umrissenen Test kann sie Material liefern, das Bewertende mögen. Sie ist aber auch kein Ersatz für die Entscheidung, weshalb ausgerechnet dieser Witz jetzt in diese Gruppe passt. Die Produktivität des Generators und die soziale Treffgenauigkeit des Posts sind verschiedene Größen.
Wer einen KI-Meme für Freunde baut, kann sich deshalb eine produktive Frage stellen: Würde ich die Pointe noch erzählen wollen, wenn das Bild nur mittelmäßig wäre? Falls ja, unterstützt die Technik einen vorhandenen Gedanken. Falls nein, trägt vielleicht nur der Überraschungseffekt der Erzeugung. Der ist kurzlebig. Die geteilte Erinnerung daran, weshalb alle gelacht haben, hält länger.
Auch die Versuchsanordnung setzt Grenzen: Menschen bewerteten konkrete erzeugte Memes unter Studienbedingungen, nicht eine jahrelang gewachsene Chatgruppe mit ihren Anspielungen. Die Messwerte helfen, ein pauschales Effizienzversprechen zu prüfen. Sie entscheiden nicht, ob eine Figur in einem bestimmten Freundeskreis nach dem zehnten Repost noch lustig ist. Dort verändert die Wiederholung selbst die Pointe. Was zuerst absurd war, kann zur Gewohnheit oder zum Anlass für einen neuen, besseren Gegenscherz werden. [7]
TikTok kennzeichnet, wenn die Spur mitkommt
TikTok erklärte 2024, KI-Inhalte aus bestimmten anderen Plattformen anhand von Content Credentials automatisch kennzeichnen zu können. Diese C2PA-Daten werden der Mediendatei mitgegeben. Die eigene Mitteilung sagt zugleich, dass die automatische Kennzeichnung mit der Verbreitung solcher Metadaten erst allmählich wachsen kann. Das ist eine verfügbare Funktion mit einer eingebauten Bedingung, kein Versprechen, jedes synthetische Bild zu finden. [1]
Im November 2025 beschrieb TikTok weitere Wege: Kennzeichnung durch Ersteller, eigene Erkennung und C2PA. In derselben Mitteilung kündigte die Plattform einen Test an, mit dem Nutzer den Anteil KI-generierter Inhalte im „For You“-Feed beeinflussen sollten. Der Unterschied in den Verben ist entscheidend. Kennzeichnung wird als bestehende Praxis beschrieben; die Steuerung wurde als Test für die folgenden Wochen angekündigt. Aus einer alten Ankündigung lässt sich ohne aktuellen Produkttest keine allgemeine Verfügbarkeit im Konto eines Lesers ableiten. [2]
Für den Gruppenchat heißt das: Ein TikTok-Label kann eine gute Information sein. Es sagt, weshalb man ein Bild nicht als Aufnahme nehmen sollte. Fehlt es, ist die Datei dadurch nicht plötzlich authentisch. Zwischen Generator, Export, Upload, Screenshot und neuem Repost liegen mehrere Gelegenheiten, an denen Informationen fehlen können. Der letzte Satz ist eine technische Folgerung aus der Abhängigkeit der Kennzeichnung von erhaltenen Signalen, keine Messung ihrer Häufigkeit.
TikTok ist dabei nur ein Ort in der Reise des Witzes. Ein Freund kann das Video außerhalb der Plattform speichern oder als Standbild in einen Messenger schicken. Was in der App als Hinweis gut sichtbar war, muss beim Empfänger nicht dieselbe Form haben. Daraus folgt keine Pflicht, jedes Meme wie Beweismaterial zu archivieren. Es folgt eine bescheidenere Gewohnheit: Wenn die künstliche Machart für das Verstehen wichtig ist, gehört sie in den eigenen Begleitsatz und nicht ausschließlich in ein Plattformfeld.
YouTube trennt Fantasie und falsche Wirklichkeit
YouTube verlangt von Erstellern die Offenlegung, wenn KI eine realistisch wirkende Szene wesentlich erzeugt oder verändert: etwa wenn eine reale Person etwas scheinbar sagt, was sie nicht gesagt hat, oder ein reales Ereignis anders erscheint. Die Hilfe nennt ausdrücklich eine Fantasieszene mit einem Einhorn als Beispiel, das diese Offenlegungspflicht nicht auslöst. Damit behandelt YouTube ein offenkundig unmögliches Meme anders als ein glaubhaft aussehendes Video einer echten Person. [3]
Das ist keine Freikarte für jede Fantasie. Ein absurder Clip kann jemanden mit Namen diffamieren, ein realer Ort kann als Schauplatz einer erfundenen Katastrophe erscheinen. Aber die Unterscheidung hilft dem Publikum: Bei einer erkennbar erfundenen Kreatur geht es zuerst um Humor, Rechte und Kontext. Bei einer scheinbaren Aufnahme kommt die Frage nach Wahrheit und Herkunft sofort hinzu.
YouTube kann Labels laut eigener Hilfe auch automatisch aus seinen Werkzeugen, C2PA-Metadaten oder internen Systemen ableiten. Eine Creator-Mitteilung aus 2026 beschreibt weitere Änderungen in Studio, unter anderem die Übersicht automatisch markierter Videos. Solche Produktpflege ist Fortschritt, aber gerade ihre fortlaufende Änderung widerspricht der Vorstellung eines fertig geschlossenen Erkennungssystems. [3] [9]
Der Zuschauer sieht im Idealfall ein Warnsignal, keine vollständige Produktionsakte. Aus dem sichtbaren Hinweis lässt sich meist nicht ablesen, welcher Satz von einem Menschen stammt, ob ein Gesicht mit Einwilligung benutzt wurde oder ob der Text außerhalb des Videos etwas Falsches behauptet. Deshalb sollte die Kennzeichnung die nächste Frage öffnen, statt sie zu beenden. Gerade bei angeblich realen Ereignissen ist der Originalkontext wichtiger als die Fertigkeit, einzelne Bildfehler zu suchen.
Ein Herkunftsschild ist kein Wahrheitsstempel
C2PA nennt seine signierten Herkunftsinformationen Content Credentials. Sie können Aussagen darüber tragen, wo eine Datei entstand und welche Bearbeitungen ein unterstütztes Werkzeug verzeichnete. Ein gültiger Nachweis bedeutet, dass diese Aussagen in der geprüften Kette nicht unbemerkt verändert wurden. Er sagt nicht, ob die abgebildete Situation tatsächlich stattgefunden hat. Der offizielle C2PA-Explainer formuliert diese Grenze ausdrücklich. [5]
Selbst eine sauber signierte Kameraaufnahme kann ein inszeniertes Ereignis zeigen. Umgekehrt kann ein synthetisches Bild ehrlich als Fiktion geteilt werden. Das Zertifikat ist also eine Antwort auf „Welche Spur hat diese Datei?“ und nicht auf „Soll ich der Behauptung in der Bildunterschrift glauben?“. Für letzteres bleiben Quelle, Kontext und gegebenenfalls weitere Belege nötig.
Der Standard erklärt auch, dass Metadaten entfernt werden können und Bearbeitungen mit nicht unterstützten Werkzeugen eine Lücke in der Kette lassen können. Meta schreibt für Facebook, Instagram und Threads ebenfalls, dass unsichtbare Kennzeichen nicht alle KI-Inhalte erfassen und entfernt werden können. Ein fehlendes Schild ist deshalb keine positive Echtheitsprüfung. Es ist zunächst nur fehlende Information. [5] [4]
Für Memes ist diese Nüchternheit befreiend. Ein Label muss den Witz nicht töten. Es kann ihn sogar sauberer machen: „synthetisch“ erklärt die Machart, während die Pointe in der Beziehung zwischen Bild, Satz und Publikum liegt. Das Problem beginnt dort, wo ein Repost das Label verliert und zugleich eine reale Behauptung andeutet.
Das Gegenstück gilt ebenfalls: Ein ehrliches Credential macht einen schlechten Witz nicht gut. Es kann die Urheberschaft oder Bearbeitung verständlicher machen, aber keine Rücksicht auf eine betroffene Person erzwingen. Diese Trennung ist ein gutes Korrektiv gegen magische Technikversprechen. Man kann einen Signaturpfad prüfen und danach immer noch zum Schluss kommen, dass die Bildunterschrift unfair, falsch oder einfach langweilig ist. Die Technik liefert eine Spur; die Redaktion oder die Runde übernimmt das Urteil. [5]
Eine Kennzeichnung hat einen Anlass, keinen Zauber
Seit dem 2. August 2026 gelten die Transparenzpflichten des EU AI Act nach Artikel 50. Die Europäische Kommission erläutert in ihrer FAQ, dass der Kontext zählt: private, nicht berufliche Nutzung ist anders einzuordnen als professionelle Veröffentlichung; bei erkennbar künstlerischen, kreativen oder satirischen Werken ist die Form der Offenlegung so zu wählen, dass sie den Genuss nicht unnötig stört. Bei täuschend echt wirkenden Inhalten kann ein klarer Hinweis beim ersten Kontakt nötig sein. Das ist eine allgemeine Einordnung, keine Rechtsbewertung eines konkreten Posts. [6]
Für die praktische Entscheidung braucht ein Gruppenchat nicht zuerst eine juristische Fallanalyse. Wer ein realistisches synthetisches Bild teilt, kann den Kontext direkt mitschicken: „KI-Bild, fiktive Szene“. Wer einen Witz über eine reale Person macht, sollte zusätzlich fragen, ob die Person durch die neue Behauptung beschädigt wird. Selbst ein vorhandenes Plattformlabel übernimmt diese Verantwortung nicht.
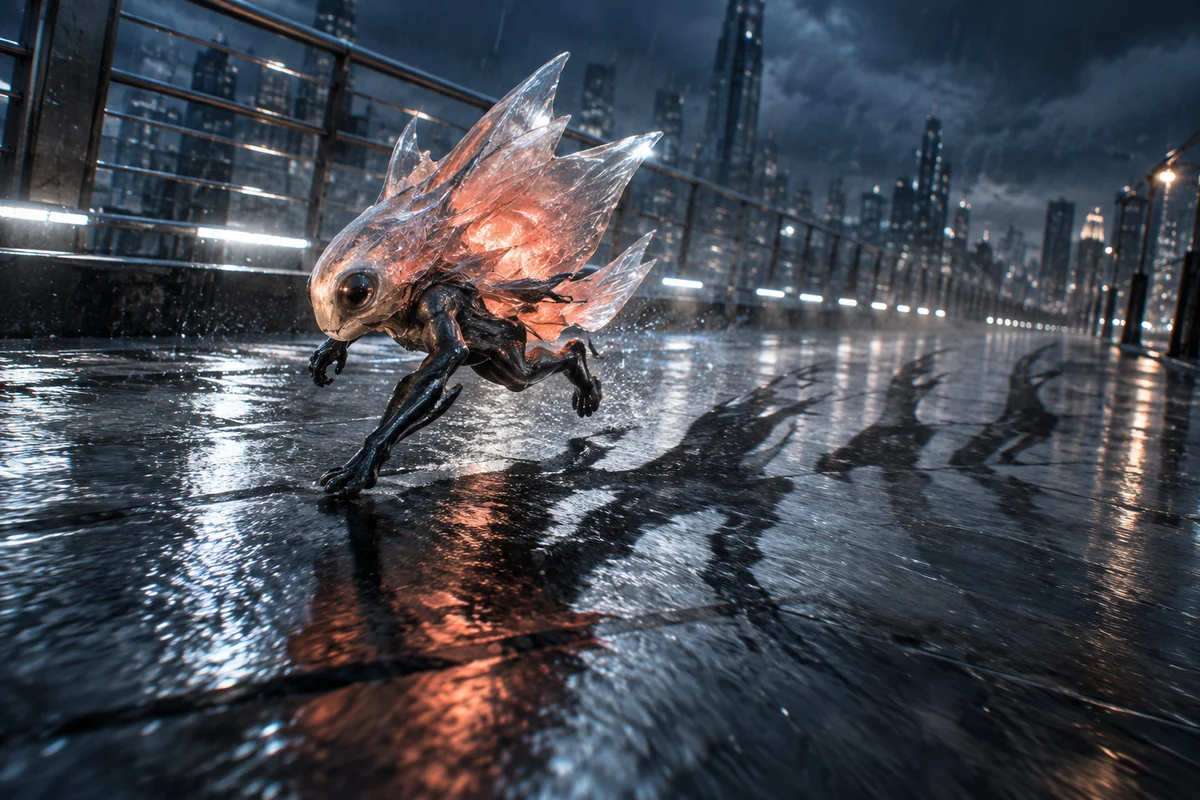
Die Redaktion wendet die Regel bei diesem Artikel sichtbar an: Das Titelmotiv ist eine originäre, fotorealistische und unmögliche Symbolszene. Es wird als „KI-generiertes Symbolbild“ gekennzeichnet und beansprucht weder eine reale Brücke noch eine dokumentierte Kreatur. Die Kennzeichnung verrät die Machart. Der Text erklärt die Deutung.
Diese sichtbare Selbstbeschreibung ist mehr als ein Pflichtkästchen. Sie zeigt, wie eine Veröffentlichung den technischen Hinweis mit einer verständlichen Aussage verbinden kann. Jemand, der nur das Bild sieht, soll wissen, dass keine Aufnahme einer realen Begegnung vorliegt. Jemand, der den Artikel liest, bekommt zusätzlich die Gründe, weshalb wir die Herkunftsdaten von der Wahrheit einer Behauptung trennen. Die beiden Ebenen ergänzen sich; keine ersetzt die andere.
Drei Sätze vor dem nächsten Weiterleiten
Wenn morgen ein neues KI-Meme in der Runde landet, lohnt sich eine kurze, konkrete Trennung. Erstens: Was ist jetzt wirklich verfügbar? TikTok kann bestimmte C2PA-Signale lesen; YouTube bietet Offenlegung und automatische Labels; Meta arbeitet mit technischen Hinweisen und beschreibt selbst Erkennungslücken. Zweitens: Was bleibt offen? Ein Herkunftslabel erklärt keine Pointe, keine Zustimmung der Betroffenen und keine Wahrheit über eine reale Szene. Drittens: Was ist nur angekündigt? Eine getestete Feed-Steuerung oder die nächste Version eines Erkennungssystems ist noch keine Eigenschaft des heutigen Posts. [1] [2] [3] [4]
Diese drei Fragen sind kein Prüfprotokoll für jeden albernen Tierwitz. Sie werden relevant, sobald ein Bild den geschützten Kontext seiner Runde verlässt oder als Beleg für etwas Reales gelesen werden könnte. Dann reicht oft ein menschlicher Satz: „Das ist ein KI-Bild und bei uns ein Witz über den Montag, keine Aufnahme.“ Wer diesen Satz nicht guten Gewissens dazuschreiben kann, muss das Bild vielleicht nicht weitertragen.
Maschinen können die seltsame Kreatur bauen. Plattformen können Spuren markieren. Aber der Moment, in dem ein Freund versteht, weshalb genau dieses Bild jetzt passt, bleibt eine gemeinsame Leistung. Eine Roadmap ist noch keine Gegenwart, auch wenn sie schon hübsche Screenshots hat. Und ein schneller Repost ist noch kein guter Witz.
Vielleicht ist die stärkste Funktion der ganzen KI-Memekultur darum erstaunlich alt: Jemand wählt ein Bild für genau diese Menschen aus, fügt den entscheidenden Satz hinzu und merkt, wann er besser schweigt. Generierung senkt die Hürde für das Bild. Sie erhöht nicht automatisch die Qualität der Einladung. Wer das auseinanderhält, kann über einen absurden synthetischen Flossenläufer lachen und bei einer scheinbaren Nachricht trotzdem rechtzeitig nach der Quelle fragen.
Originalquellen zu Memes, Kennzeichnung und Herkunft
- TikTok Newsroom – Content Credentials und automatische KI-Kennzeichnung (platform-primary-release)
- TikTok Newsroom – KI-Kennzeichnung und angekündigte Feed-Steuerung (platform-primary-release)
- YouTube Hilfe – Offenlegung synthetischer Inhalte (platform-primary-help)
- Meta Newsroom – KI-Labels auf Facebook, Instagram und Threads (platform-primary-release)
- C2PA – offizieller Content-Credentials-Explainer 2.4 (standards-primary-document)
- Europäische Kommission – FAQ zu Transparenzpflichten nach Artikel 50 (regulator-primary-guidance)
- Wu, Weber und Müller – One Does Not Simply Meme Alone, IUI 2025 (research-original-study)
- Know Your Meme – Italian Brainrot / AI Italian Animals (culture-original-archive)
- YouTube Creator-Mitteilung – Updates to AI content disclosure and labels 2026 (platform-primary-update)
Recherche- und Redaktionsstand: 9. Oktober 2026. Redaktionell verantwortlich: Benjamin Metzig.